RAG Nedir? Şirket Verileri Yapay Zekâya Nasıl Bağlanır?
RAG Nedir? Şirket Verileri Yapay Zekâya Nasıl Bağlanır?
Yapay zekâ sistemleri artık yalnızca genel soruları cevaplayan araçlar olmaktan çıkıyor. Şirketler; kendi ürünlerini, müşterilerini, prosedürlerini, teknik dokümanlarını, tekliflerini, sözleşmelerini, CRM kayıtlarını ve kurumsal bilgi birikimini anlayabilen yapay zekâ sistemleri oluşturmak istiyor.
Burada en önemli soru ortaya çıkıyor:
Bir yapay zekâ modeli şirketin kendi verilerine nasıl erişebilir?
Bu sorunun günümüzdeki en önemli teknik cevaplarından biri RAG (Retrieval-Augmented Generation), Türkçede yaygın kullanılan ifadeyle erişim veya bilgi getirme destekli üretim mimarisidir.
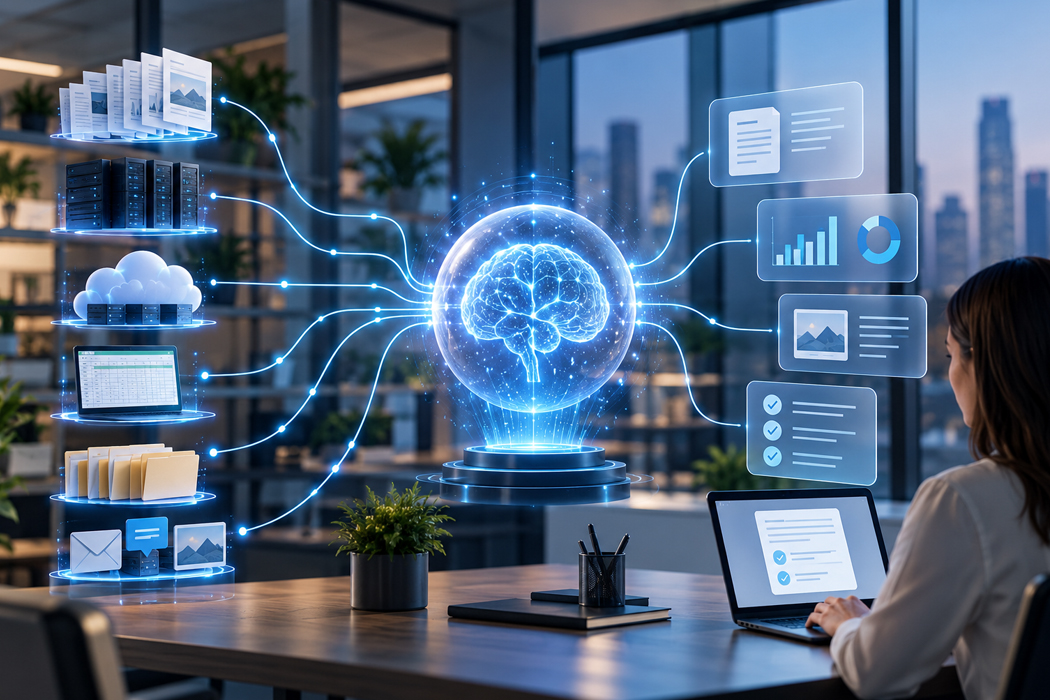
RAG sayesinde büyük dil modellerinin yalnızca eğitim sırasında öğrendiği bilgilerle cevap vermesi yerine şirketin izin verilen güncel veri kaynaklarından ilgili bilgileri bulması, bunları değerlendirmesi ve kullanıcıya bu bilgiler doğrultusunda yanıt üretmesi sağlanabilir.
Örneğin çalışanınız yapay zekâ sistemine:
“ABC müşterisine geçen ay hangi ürünler için teklif gönderdik?”
diye sorduğunda sistemin internetten veya modelin genel bilgisinden cevap üretmesi yerine şirketinizin yetkili CRM, teklif sistemi veya doküman havuzundaki ilgili kayıtları bulması hedeflenir.
Benzer şekilde:
“Bu makinenin bakım prosedürü nedir?”
“İade prosedürümüz kaç gün?”
“2026 fiyat listesinde X ürününün bayi fiyatı nedir?”
“Geçen yıl hazırladığımız benzer projeler hangileri?”
“ISO prosedürümüzde bu konuyla ilgili hangi madde bulunuyor?”
gibi sorular şirket içi bilgi kaynakları üzerinden yanıtlanabilir.
RAG bu nedenle yalnızca bir yapay zekâ özelliği değil; doğru tasarlandığında şirket bilgilerinin çalışanlar, müşteriler veya yetkilendirilmiş uygulamalar tarafından daha hızlı kullanılmasını sağlayabilecek bir kurumsal bilgi erişim mimarisidir.
Şirketinizde yapay zekânın CRM, ERP, dokümanlar, veri tabanları veya farklı yazılım sistemleriyle nasıl birlikte çalışabileceğini değerlendirmek istiyorsanız Reform Bilişim Teknolojileri ile iletişime geçebilirsiniz. İlk görüşme ücretsizdir. Böylece proje kararı vermeden önce mevcut yazılım altyapınız, veri kaynaklarınız ve uygulanabilecek yapay zekâ senaryoları değerlendirilebilir.
RAG Açılımı Nedir?
RAG, İngilizce Retrieval-Augmented Generation ifadesinin kısaltmasıdır.
Mimari temel olarak iki ana yeteneği birleştirir:
Retrieval: Kullanıcının sorusuyla ilgili bilgilerin harici bir bilgi kaynağından bulunması.
Generation: Bulunan bilgiler kullanılarak büyük dil modeli tarafından anlamlı bir cevap oluşturulması.
RAG yaklaşımının akademik olarak yaygınlaşmasındaki temel çalışmalardan biri Patrick Lewis ve çalışma arkadaşlarının NeurIPS 2020’de yayımlanan Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks araştırmasıdır.
Çalışmada dil modellerinin parametrik bilgisinin harici bilgi kaynaklarıyla desteklenmesi ele alınmıştır.
Bugünkü kurumsal RAG sistemleri orijinal mimariden önemli ölçüde gelişmiş olsa da temel fikir aynıdır:
Modelin her bilgiyi ezberlemesini beklemek yerine ihtiyaç duyduğu bilgiyi doğru kaynaktan bulmasını sağlamak.
Bu yaklaşım özellikle sürekli değişen şirket verileri açısından önemlidir.
Çünkü ürün fiyatları, stok durumu, prosedürler, sözleşmeler, müşteri bilgileri ve operasyonel kayıtlar sürekli değişebilir.
Modeli her değişiklikte yeniden eğitmek yerine bilgi kaynağını güncel tutmak çok daha uygulanabilir olabilir.
RAG Sistemi Nasıl Çalışır?
Basitleştirilmiş bir RAG sistemi şu akışla düşünülebilir:
Kullanıcı sorusu → ilgili şirket bilgisinin aranması → uygun içeriğin bulunması → içeriğin yapay zekâ modeline bağlam olarak verilmesi → cevabın oluşturulması.
Örneğin şirketinizin yüzlerce teknik PDF dokümanı bulunduğunu düşünelim.
Kullanıcı:
“X500 cihazında E12 hatası çıkarsa hangi kontroller yapılmalı?”
diye soruyor.
Standart bir büyük dil modeli şirketinizin X500 cihazını hiç tanımıyor olabilir.
RAG altyapısı ise kullanıcı sorusunu analiz eder, şirketin teknik dokümanlarında ilgili bölümleri arar, X500 ve E12 hatasıyla ilişkili içerikleri bulur ve yalnızca gerekli bölümleri yapay zekâ modeline gönderir.
Model daha sonra cevabı bu bilgiler üzerinden oluşturabilir.
Böylece yapay zekâ modeliyle şirketin kurumsal bilgi kaynakları arasında dinamik bir bağlantı kurulmuş olur.
Şirket Verileri Doğrudan Yapay Zekâ Modeline mi Yüklenir?
Her zaman değil.
RAG konusunda en sık karşılaşılan yanlış anlaşılmalardan biri şirket verilerinin tamamının doğrudan yapay zekâ modeline öğretilmesi gerektiğinin düşünülmesidir.
RAG mimarisinde çoğu durumda amaç modelin ağırlıklarını şirket verileriyle yeniden eğitmek değildir.
Bunun yerine şirket bilgileri ayrı bir veri altyapısında tutulur.
Kullanıcının sorusuna göre yalnızca ilgili bilgiler bulunarak modele bağlam olarak gönderilir.
Bu fark oldukça önemlidir.
Örneğin şirketinizin 50.000 sayfalık teknik doküman arşivi varsa her soru için 50.000 sayfanın tamamının modele gönderilmesi verimsiz olacaktır.
RAG sistemi önce ilgili birkaç metin parçasını belirler.
Daha sonra yalnızca gerekli bağlamı modele sunar.
Bu nedenle başarılı bir RAG projesinin önemli bölümü yalnızca yapay zekâ modelinden değil, veri hazırlama, arama, indeksleme, yetkilendirme ve entegrasyon mimarisinden oluşur.
Şirket Verileri RAG Sistemine Nasıl Hazırlanır?
Kurumsal RAG projelerinde ilk aşamalardan biri kullanılacak veri kaynaklarının belirlenmesidir.
Bunlar arasında:
- PDF dokümanları
- Word ve Excel dosyaları
- ürün katalogları
- teknik dokümanlar
- şirket prosedürleri
- kullanım kılavuzları
- CRM kayıtları
- ERP verileri
- destek talepleri
- e-posta arşivleri
- web sitesi içerikleri
- intranet sayfaları
- SQL veri tabanları
- API üzerinden erişilen sistemler
- müşteri destek bilgi bankaları
bulunabilir.
Ancak şirketin sahip olduğu bütün verileri kontrolsüz biçimde sisteme aktarmak doğru değildir.
Öncelikle hangi verilerin kullanılacağı, verinin güncelliği, erişim izinleri, kişisel veriler, ticari sırlar ve kullanıcı rollerinin değerlendirilmesi gerekir.
Bu nedenle RAG projesi yalnızca “PDF’leri yapay zekâya yüklemek” şeklinde ele alınmamalıdır.
Embedding Nedir ve RAG Sisteminde Neden Kullanılır?
RAG sistemlerini anlamak için bilinmesi gereken temel kavramlardan biri embedding teknolojisidir.
Embedding, bir metnin anlamını matematiksel bir sayı dizisiyle temsil etmeye yarayan yöntemlerden biridir.
Basit bir örnek düşünelim.
Kullanıcı:
“Personelin yıllık izin hakkı kaç gün?”
diye soruyor.
Şirket dokümanında ise:
“Çalışanların yıllık ücretli izin süreleri…”
şeklinde bir ifade olabilir.
Kelimeler birebir aynı değildir.
Klasik anahtar kelime araması bazı durumlarda bu ilişkiyi yakalamakta zorlanabilir.
Embedding tabanlı anlamsal arama ise iki metnin anlam açısından yakın olduğunu belirlemeye yardımcı olabilir.
Bu sayede kullanıcı dokümandaki ifadeyi birebir bilmese bile ilgili bilgiye ulaşabilir.
Vektör Veritabanı Nedir?
Embedding’ler oluşturulduktan sonra bunların aranabilir bir yapıda saklanması gerekir.
Bu noktada RAG mimarilerinde sıklıkla vektör indeksleri veya vektör veritabanları kullanılır.
Bir dokümandan oluşturulan metin parçaları embedding modelinden geçirilerek sayısal temsillere dönüştürülebilir.
Kullanıcı bir soru sorduğunda aynı işlem soru için de gerçekleştirilir.
Daha sonra sistem kullanıcının sorusuna anlam açısından en yakın içerikleri belirlemeye çalışır.
Ancak kurumsal projelerde yalnızca vektör benzerliğine güvenmek her zaman yeterli değildir.
Anahtar kelime araması, metadata filtreleme, kullanıcı yetkileri ve yeniden sıralama gibi yöntemler de sisteme eklenebilir.
Bu nedenle gelişmiş yapılarda hibrit arama yaklaşımı tercih edilebilir.
Microsoft’un gelişmiş RAG mimarileri üzerine teknik dokümantasyonu da veri alımı, içerik parçalama, arama ve güncelleme stratejilerinin gerçek dünyadaki sistemlerde önemli olduğunu vurgulamaktadır.
Chunking Nedir? Belgeler Neden Parçalara Ayrılır?
Bir RAG sisteminde uzun dokümanlar çoğu zaman tek parça olarak indekslenmez.
Bunun yerine içerik daha küçük anlamlı bölümlere ayrılır.
Bu işleme chunking denir.
Örneğin 150 sayfalık bir kullanım kılavuzunun tamamını tek kayıt olarak saklamak yerine başlıklar, bölümler veya belirli uzunluklardaki metin parçaları ayrı ayrı indekslenebilir.
Chunk boyutu çok büyük olursa gereksiz bilgiler modele taşınabilir.
Çok küçük olursa bir konunun anlam bütünlüğü kaybolabilir.
Bu nedenle ideal chunk stratejisi;
belgenin yapısına,
soru türlerine,
kullanılan embedding modeline,
arama yöntemine
ve yapay zekâ modelinin bağlam kapasitesine göre belirlenmelidir.
Akademik literatürde RAG sistemlerinin retrieval, augmentation ve generation bileşenlerinin birlikte optimize edilmesinin önemini inceleyen kapsamlı çalışmalar bulunmaktadır. Bu konuda Retrieval-Augmented Generation for Large Language Models: A Survey araştırması ayrıntılı bir akademik çerçeve sunmaktadır.
RAG ile ChatGPT Arasındaki Fark Nedir?
ChatGPT gibi büyük dil modeli tabanlı sistemler genel amaçlı yapay zekâ uygulamalarıdır.
RAG ise tek başına belirli bir sohbet robotunun adı değildir.
RAG, bir yapay zekâ modelinin harici bilgi kaynaklarından bilgi bulmasını ve bu bilgiyi cevap oluştururken kullanmasını sağlayan mimari yaklaşımdır.
Bu nedenle OpenAI, Azure, AWS veya farklı model sağlayıcılarıyla RAG benzeri sistemler geliştirilebilir.
Ayrıca açık kaynak modeller şirket içinde veya özel sunucu altyapılarında çalıştırılarak da çeşitli RAG mimarileri oluşturulabilir.
Doğru teknoloji seçimi şirketin;
veri güvenliği gereksinimleri,
bütçesi,
kullanıcı sayısı,
veri hacmi,
entegrasyon ihtiyaçları,
cevap süresi beklentisi,
model kalitesi gereksinimleri
ve ölçeklenme hedeflerine göre değişebilir.
RAG ile Şirket İçi ChatGPT Yapılabilir mi?
Evet. Şirketlerin RAG teknolojisine ilgi göstermesinin önemli nedenlerinden biri kendi bilgi kaynaklarıyla çalışan kurumsal yapay zekâ asistanları oluşturabilme imkânıdır.
Örneğin şirket çalışanları tek bir sohbet ekranından:
İnsan Kaynakları: İzin prosedürlerini sorabilir.
Satış: Ürün ve fiyat bilgilerine ulaşabilir.
Teknik Servis: Arıza ve bakım dokümanlarında arama yapabilir.
Yönetim: Rapor ve operasyon verilerine erişebilir.
Müşteri Hizmetleri: Ürün dokümanlarından hızlı cevap bulabilir.
Yeni Personel: Şirket prosedürleri hakkında bilgi alabilir.
Ancak herkesin her bilgiye erişebilmesi doğru değildir.
Bu nedenle kurumsal yapay zekâ projelerinde kullanıcı yetkilendirmesi kritik önem taşır.
RAG Sistemlerinde Yetkilendirme Nasıl Yapılmalıdır?
Bir şirket düşünelim.
Satış personeli fiyat listelerini ve müşteri tekliflerini görebiliyor.
İnsan kaynakları çalışanları personel dosyalarına erişebiliyor.
Muhasebe departmanı finansal verilere ulaşabiliyor.
Teknik servis ise ürün dokümanlarını kullanıyor.
Bu şirketin yapay zekâ sistemine tüm veriler bağlanır ve erişim kontrolü uygulanmazsa ciddi bilgi güvenliği problemleri ortaya çıkabilir.
Örneğin satış personelinin:
“Şirket çalışanlarının maaşlarını listele.”
sorusuna cevap alabilmesi istenmeyebilir.
Bu nedenle RAG sisteminin yalnızca doğru bilgiye ulaşması değil, doğru kullanıcının doğru bilgiye ulaşması gerekir.
Kullanıcı rolleri, departmanlar, kayıt bazlı yetkiler, doküman bazlı erişim ve veri kaynağı izinleri sistem mimarisinin bir parçası olmalıdır.
Kurumsal RAG projesinin mevcut CRM, ERP veya yönetim yazılımıyla birlikte geliştirilmesi gerektiğinde Reform Bilişim Web Yazılım Çözümleri kapsamında özel web tabanlı uygulamalar ve entegrasyonlar birlikte değerlendirilebilir.
CRM Verileri Yapay Zekâya Bağlanabilir mi?
Teknik altyapısı uygun sistemlerde CRM verileri API veya veri tabanı entegrasyonları aracılığıyla yapay zekâ destekli uygulamalara bağlanabilir.
Örneğin bir satış yöneticisi:
“Son 30 gündür iletişim kurulmamış potansiyel müşterileri getir.”
“Geçen ay gönderilen ancak cevap alınamayan teklifleri listele.”
“ABC müşterisiyle yaptığımız görüşmeleri özetle.”
“Satış fırsatlarını sektörlerine göre sınıflandır.”
gibi doğal dil sorguları kullanabilir.
Burada RAG’ın tek başına yeterli olmadığı durumlar da vardır.
Canlı CRM kayıtlarında doğru filtreleme ve hesaplama gerektiğinde klasik veri tabanı sorguları, API işlemleri ve yapay zekâ araç kullanımı birlikte tasarlanabilir.
Dolayısıyla kurumsal yapay zekâ mimarisi her zaman sadece vektör veritabanından oluşmak zorunda değildir.
ERP Verileri Yapay Zekâya Bağlanabilir mi?
Benzer şekilde ERP sistemlerindeki uygun veriler de yapay zekâ katmanına entegre edilebilir.
Örneğin:
“Stoku kritik seviyenin altına düşen ürünler hangileri?”
“Geçen aya göre siparişi en fazla artan ürünleri göster.”
“Bu hafta teslim edilmesi gereken siparişleri listele.”
gibi sorular operasyonel verilerle ilişkilendirilebilir.
Ancak sayısal doğruluk gerektiren durumlarda yalnızca semantik RAG araması kullanmak yerine yapılandırılmış sorguların çalıştırılması daha doğru olabilir.
Kurumsal AI sistemlerinin önemli bir tasarım kararı da burada ortaya çıkar:
Hangi soruda doküman araması yapılmalı, hangi soruda veri tabanı sorgulanmalı, hangi durumda API kullanılmalı?
Başarılı bir özel yazılım ve yapay zekâ entegrasyonu bu ayrımı doğru yapmalıdır.
Şirket sistemlerinin API, CRM ve ERP bağlantılarıyla birlikte nasıl kurgulanabileceği hakkında daha geniş bilgi için Yapay Zeka İşletmelere Nasıl Entegre Edilir? içeriği de incelenebilir.
RAG Yapay Zekâ Halüsinasyonlarını Tamamen Engeller mi?
Hayır.
RAG sistemlerinin en önemli avantajlarından biri cevapları belirli kaynaklara dayandırabilme potansiyelidir ancak bu, hatalı cevapların tamamen ortadan kalkacağı anlamına gelmez.
Sistem yanlış dokümanı bulabilir.
Doğru dokümanın yanlış bölümünü getirebilir.
Eski bir belgeyi kullanabilir.
Çelişkili belgeler arasında yanlış seçim yapabilir.
Model verilen içeriği yanlış yorumlayabilir.
Yetersiz bilgi bulunmasına rağmen kesin bir cevap oluşturabilir.
Bu nedenle kurumsal RAG sistemlerinde yalnızca “cevap üretiyor mu?” sorusuna bakmak yeterli değildir.
Retrieval kalitesi, kaynak doğruluğu, cevapla kaynak arasındaki bağlılık ve doğru cevap vermeme davranışı da test edilmelidir.
RAG sistemlerinin değerlendirilmesi üzerine yapılan Evaluation of Retrieval-Augmented Generation: A Survey çalışması retrieval ve generation bileşenlerinin doğruluk, relevance ve faithfulness gibi ölçütlerle ayrı ayrı değerlendirilmesinin önemini ele almaktadır.
RAG mı Fine-Tuning mi?
RAG ile fine-tuning sıkça birbirine karıştırılır ancak farklı amaçlara hizmet eder.
RAG, modele dışarıdan güncel bilgi sağlamaya odaklanır.
Fine-tuning ise modelin belirli bir davranış, format, görev veya veri örüntüsüne daha iyi uyum sağlaması için model parametrelerinin ek eğitimle değiştirilmesini içerir.
Örneğin şirketinizin ürün fiyatları sürekli değişiyorsa bunları fine-tuning ile modele öğretmek çoğu senaryoda uygun olmayabilir.
Fiyat listesi güncellendiğinde modelin tekrar eğitilmesi gerekecektir.
RAG yapısında ise güncel fiyat kaynağı değiştirilir ve sistem yeni kaynağı kullanabilir.
Buna karşılık modelin belirli bir sınıflandırma görevini veya şirketin özel cevap formatını öğrenmesi isteniyorsa fine-tuning farklı bir seçenek olabilir.
Bazı projelerde RAG ve fine-tuning birlikte de kullanılabilir.
Dolayısıyla “hangisi daha iyi?” sorusundan önce hangi problemin çözülmeye çalışıldığının belirlenmesi gerekir.
RAG mı Uzun Context Yapay Zekâ Modelleri mi?
Yeni nesil büyük dil modellerinin aynı anda çok daha uzun belgeleri okuyabilmesi başka bir soruyu beraberinde getirmiştir:
“Bütün dosyayı modele gönderebiliyorsak RAG’a hâlâ ihtiyaç var mı?”
Cevap kullanım senaryosuna bağlıdır.
Az sayıda belge ve sınırlı kullanım bulunan bazı durumlarda uzun context yaklaşımı yeterli olabilir.
Ancak binlerce veya milyonlarca doküman bulunan sistemlerde her soruda bütün veriyi modele göndermek maliyet, hız ve bilgi seçimi açısından verimsizleşebilir.
Bu konuda yayımlanan Retrieval Augmented Generation or Long-Context LLMs? A Comprehensive Study and Hybrid Approach araştırması RAG ile uzun context modellerinin avantajlarını karşılaştırmaktadır.
Çalışma, iki yöntemin kullanım senaryosuna göre farklı avantajlara sahip olabileceğini ve hibrit yaklaşımların değerlendirilebileceğini göstermektedir.
RAG Sistemlerinde Kaynak Gösterilebilir mi?
Evet ve kurumsal uygulamalarda bu oldukça faydalı bir özelliktir.
Örneğin yapay zekâ cevabının altında:
“Kaynak: Teknik Servis Prosedürü – Sayfa 18”
veya
“Kaynak: İnsan Kaynakları El Kitabı – Yıllık İzin Bölümü”
gibi referanslar gösterilebilir.
Kullanıcı böylece cevabın hangi kurumsal kaynağa dayandığını kontrol edebilir.
Bu yaklaşım özellikle hukuk, kalite, üretim, teknik servis, insan kaynakları ve finans gibi doğrulanabilirliğin önemli olduğu süreçlerde değerli olabilir.
Ancak kaynak gösterilmesi cevabın otomatik olarak doğru olduğu anlamına gelmez. Kaynağın gerçekten verilen iddiayı destekleyip desteklemediğinin de sistematik olarak değerlendirilmesi gerekir.
RAG Hangi Şirketlerde Kullanılabilir?
RAG yalnızca büyük teknoloji şirketlerinin kullanabileceği bir yapı değildir.
Yeterli dijital veri ve anlamlı bir kullanım senaryosu bulunan birçok işletmede değerlendirilebilir.
Üretim şirketleri teknik doküman ve bakım bilgileri için,
e-ticaret şirketleri ürün bilgi sistemleri için,
hizmet şirketleri müşteri destek süreçleri için,
danışmanlık firmaları kurumsal bilgi bankaları için,
lojistik şirketleri operasyon prosedürleri için,
yazılım şirketleri teknik dokümantasyon için,
insan kaynakları departmanları şirket prosedürleri için,
satış ekipleri CRM ve ürün bilgileri için
RAG tabanlı çözümlerden yararlanabilir.
Burada önemli olan şirket büyüklüğünden çok doğru kullanım senaryosudur.
RAG ile Müşteri Hizmetleri Otomatikleştirilebilir mi?
RAG’ın güçlü kullanım alanlarından biri müşteri hizmetleridir.
Standart chatbot sistemlerinde cevaplar önceden hazırlanmış sınırlı senaryolara bağlı olabilir.
RAG tabanlı yapay zekâ asistanı ise şirketin ürün dokümanlarını, yardım merkezini, kullanım kılavuzlarını ve izin verilen diğer bilgi kaynaklarını arayabilir.
Müşteri:
“Ürünümde E17 hatası çıkıyor, ne yapmalıyım?”
diye sorduğunda sistem ilgili teknik dokümanı bulabilir.
Ancak müşteriye açık yapay zekâ sistemlerinde güvenlik sınırları daha önemlidir.
Şirket içi dokümanların tamamı dış kullanıcıların erişimine açılmamalıdır.
İç bilgi bankası ile müşteri bilgi bankasının erişim katmanları ayrılmalıdır.
RAG Sistemi İnternete Bağlı Olmak Zorunda mı?
Hayır.
RAG sisteminin hangi altyapıda çalışacağı projeye göre değişebilir.
Bulut tabanlı API servisleri kullanılabileceği gibi daha kontrollü ortamlarda özel sunucular ve yerel modeller de değerlendirilebilir.
Burada önemli olan güvenlik gereksinimleri, performans beklentisi ve toplam proje maliyetidir.
Özellikle hassas veriler bulunan sistemlerde verinin hangi servislerden geçtiği, nerede işlendiği, hangi kayıtların tutulduğu ve hangi sağlayıcıların sisteme erişebildiği proje öncesinde incelenmelidir.
Şirket Verilerinin Güncellenmesi RAG Sistemine Nasıl Yansır?
Kurumsal RAG sisteminin önemli avantajlarından biri bilgi kaynağının güncellenebilmesidir.
Örneğin yeni fiyat listesi yayımlandığında eski dosyanın sistemden kaldırılması ve yenisinin indekslenmesi sağlanabilir.
Ancak güncelleme mekanizması doğru kurulmazsa yapay zekâ eski ve yeni bilgileri birlikte kullanabilir.
Bu nedenle veri yaşam döngüsü tasarlanmalıdır.
Yeni dokümanın sisteme ne zaman gireceği,
eski versiyonun nasıl kaldırılacağı,
doküman versiyonlarının tutulup tutulmayacağı,
değişikliklerin otomatik algılanıp algılanmayacağı
ve hangi kaynağın öncelikli kabul edileceği belirlenmelidir.
RAG Projesinde En Sık Yapılan Hatalar Nelerdir?
Kurumsal RAG projelerinde en sık yapılan hata, başarının yalnızca kullanılan büyük dil modeline bağlı olduğunun düşünülmesidir.
Gerçekte sonuç kalitesini veri hazırlığı ve retrieval sistemi ciddi biçimde etkileyebilir.
Başlıca hatalar arasında:
- kalitesiz veya güncel olmayan verilerin sisteme eklenmesi,
- dokümanların yanlış parçalanması,
- kullanıcı yetkilerinin dikkate alınmaması,
- yalnızca semantik benzerliğe güvenilmesi,
- yanıtların kaynaklarla doğrulanmaması,
- ölçüm ve test sistemi kurulmadan yayına çıkılması,
- gereksiz yere bütün şirket verilerinin sisteme aktarılması,
- pilot proje yapılmadan çok büyük kapsamla başlanması
bulunur.
RAG araştırmalarındaki gelişmiş yaklaşımlar da retrieval performansının kritik olduğunu göstermektedir. Örneğin ACL’de yayımlanan M-RAG: Reinforcing Large Language Model Performance through Retrieval-Augmented Generation with Multiple Partitions çalışması retrieval mimarisinin geliştirilmesine yönelik farklı yaklaşımları incelemektedir.
Bir RAG Projesine Nasıl Başlanmalıdır?
En doğru başlangıç genellikle bütün şirketi kapsayan dev bir yapay zekâ projesi yapmak değildir.
Öncelikle ölçülebilir bir problem seçilebilir.
Örneğin:
“Teknik servis çalışanlarının 5.000 sayfalık doküman arşivinde bilgi araması çok zaman alıyor.”
Bu net bir problem tanımıdır.
Pilot sistemde yalnızca teknik servis dokümanları kullanılabilir.
Sistem gerçek kullanıcı sorularıyla test edilir.
Doğru belgeyi bulma oranı,
cevap doğruluğu,
cevap süresi,
kullanıcının zaman tasarrufu
ve hatalı cevap oranı ölçülebilir.
Sonuç başarılıysa sistem diğer departmanlara genişletilebilir.
Bu yaklaşım gereksiz yatırım riskini azaltabilir.
RAG Projesinin Maliyeti Neye Göre Değişir?
RAG sistemi için herkesin kullanabileceği tek bir standart fiyat bulunmaz.
Maliyeti etkileyen başlıca unsurlar arasında veri hacmi, doküman sayısı, kullanıcı sayısı, kullanılacak yapay zekâ modeli, API maliyetleri, embedding altyapısı, arama motoru, vektör veritabanı, kullanıcı yönetimi, CRM veya ERP entegrasyonu, özel arayüz, güvenlik gereksinimleri, raporlama ve bakım süreçleri bulunur.
Örneğin yalnızca 500 teknik doküman üzerinde çalışan küçük bir şirket içi asistan ile CRM, ERP, e-posta, ürün sistemi ve müşteri destek platformunu birlikte kullanan kurumsal bir yapay zekâ sistemi aynı proje değildir.
Özel yazılım bütçelerinin hangi unsurlardan etkilendiğini daha ayrıntılı incelemek için Özel Yazılım Maliyeti Neye Göre Belirlenir? içeriğine göz atabilirsiniz.
RAG Sistemi Web Tabanlı Yazılıma Entegre Edilebilir mi?
Evet.
Kurumsal RAG uygulamaları web tabanlı bir yönetim paneli veya şirket içi portal üzerinden kullanılabilir.
Kullanıcı sisteme giriş yaptıktan sonra kendi yetkisine göre yapay zekâ asistanıyla konuşabilir.
Arka planda kullanıcı kimliği, departmanı ve erişim izinleri dikkate alınarak uygun veri kaynaklarında arama yapılabilir.
Bu yaklaşım özellikle mevcut iş yazılımlarına yapay zekâ fonksiyonları eklemek için uygundur.
Özel web tabanlı sistemlerin nasıl çalıştığı hakkında Web Tabanlı Yazılım Nedir? Masaüstü Yazılımdan Farkı yazısı incelenebilir.
RAG Mobil Uygulamaya Entegre Edilebilir mi?
Teknik altyapısı uygun olduğunda aynı yapay zekâ servisinin mobil uygulamalar üzerinden kullanılması mümkündür.
Örneğin saha personeli mobil uygulamada ürün fotoğrafı, cihaz kodu veya yazılı soruyla teknik bilgi isteyebilir.
Satış temsilcisi toplantı öncesinde müşterinin geçmiş kayıtlarını özetletebilir.
Servis personeli kullanım kılavuzunda arama yapmak yerine doğal dille soru sorabilir.
Mobil uygulama tarafında işletmeye özel çözümler için Reform Bilişim Mobil Uygulama Çözümleri sayfası incelenebilir.
RAG Sistemlerinde AI SEO ve Kurumsal İçerik Yapısı Neden Önemlidir?
RAG sistemleri şirket içi bilgi erişimi için kullanılırken web üzerindeki yapay zekâ görünürlüğü farklı bir konu olarak ele alınmalıdır.
Bununla birlikte iki alanda ortak bir ihtiyaç vardır:
Bilginin açık, düzenli, anlamlı ve makine tarafından anlaşılabilir olması.
Şirketinizin web sayfalarında hangi hizmeti verdiği belirsizse hem kullanıcıların hem arama motorlarının hem de yapay zekâ destekli arama sistemlerinin içeriği doğru yorumlaması zorlaşabilir.
Bu nedenle içerik mimarisi, konu kümeleri, net başlıklar, açıklayıcı hizmet sayfaları ve doğru iç linkleme önemlidir.
Yapay zekâ destekli arama sistemleri açısından içerik optimizasyonu hakkında daha fazla bilgi için AI SEO Nedir? Yapay Zeka Çağında SEO Rehberi içeriğini inceleyebilirsiniz.
RAG’ın Şirketlere Sağlayabileceği Avantajlar Nelerdir?
Doğru projelerde RAG tabanlı kurumsal yapay zekâ sistemleri bilgiye erişim süresini önemli ölçüde azaltabilir.
Çalışanların yüzlerce doküman arasında arama yapması yerine doğal dilde soru sorabilmesi sağlanabilir.
Yeni personelin şirket prosedürlerini öğrenmesi kolaylaştırılabilir.
Teknik ekiplerin sorun çözme süresi azaltılabilir.
Müşteri hizmetleri çalışanlarının doğru ürün bilgisine daha hızlı ulaşması sağlanabilir.
Kurumsal bilgi kişilerin bilgisayarlarında veya bireysel deneyimlerinde dağınık kalmak yerine merkezi bir bilgi altyapısıyla kullanılabilir.
Ancak bu faydalar otomatik olarak ortaya çıkmaz.
Doğru veri, doğru retrieval mimarisi, doğru erişim kontrolü ve sürekli değerlendirme gerekir.
RAG Kurmak İçin Önce Yapılması Gereken Analiz Nedir?
Teknoloji seçmeden önce işletmenin gerçek ihtiyacı belirlenmelidir.
İlk görüşmede şu sorular ele alınabilir:
Şirketin hangi bilgilerine erişmek zor?
Çalışanlar en fazla hangi bilgiyi arıyor?
Veriler hangi sistemlerde tutuluyor?
Hangi sistemlerin API erişimi bulunuyor?
Belgeler ne sıklıkla güncelleniyor?
Kim hangi bilgiye erişebilmeli?
Yapay zekâ yalnızca bilgi mi vermeli, yoksa işlem de yapmalı mı?
Kaç kullanıcı sistemi kullanacak?
Hangi cevaplarda kaynak göstermek zorunlu?
Hatalı cevap verilmesinin iş açısından riski nedir?
Bu soruların cevapları teknik mimariyi doğrudan değiştirebilir.
Reform Bilişim Teknolojileri ile RAG ve Kurumsal Yapay Zekâ Entegrasyonu
RAG sistemi kurmak yalnızca bir yapay zekâ API’sine bağlanmak değildir.
Gerçek bir kurumsal çözümde şirket verilerinin analiz edilmesi, veri kaynaklarının hazırlanması, API entegrasyonlarının kurulması, kullanıcı yetkilerinin belirlenmesi, arama sisteminin tasarlanması, yapay zekâ modelinin entegre edilmesi, kullanıcı arayüzünün geliştirilmesi ve sistemin gerçek sorularla test edilmesi gerekir.
Reform Bilişim Teknolojileri’nin özel web yazılım çözümleri kapsamında CRM ve ERP bağlantıları, API entegrasyonları, yönetim panelleri ve işletmeye özel web tabanlı uygulamalar geliştirilebildiği için RAG ve yapay zekâ projeleri mevcut dijital altyapıyla birlikte planlanabilir.
Şirketinizde;
dokümanlarla konuşabilen yapay zekâ,
şirket içi AI asistanı,
CRM verilerini analiz eden yapay zekâ,
ERP verilerine doğal dille erişim,
müşteri destek chatbotu,
teknik doküman asistanı,
ürün bilgi asistanı
veya farklı bir RAG uygulaması düşünüyorsanız öncelikle kullanım senaryosunun teknik olarak analiz edilmesi gerekir.
Reform Bilişim Teknolojileri’nde ilk görüşme ücretsizdir.
Henüz hangi yapay zekâ modelini, hangi vektör veritabanını veya hangi teknik altyapıyı kullanacağınızı bilmeniz gerekmez.
Öncelikle işletmenizde çözülmesi gereken problem, mevcut veri kaynakları ve hedeflenen iş akışı değerlendirilerek uygun sistem mimarisi belirlenebilir.
Projenizi değerlendirmek için Reform Bilişim Teknolojileri iletişim sayfasından ulaşabilirsiniz.
Sıkça Sorulan Sorular
RAG nedir?
RAG, Retrieval-Augmented Generation ifadesinin kısaltmasıdır. Büyük dil modelinin cevap üretmeden önce harici bir bilgi kaynağından ilgili bilgileri bulmasını ve bu bilgileri cevap oluştururken kullanmasını sağlayan yapay zekâ mimarisidir.
RAG’ın Türkçe karşılığı nedir?
Türkçede erişim destekli üretim, bilgi getirme destekli üretim veya erişim artırımlı üretim gibi karşılıklar kullanılmaktadır. Teknik içeriklerde genellikle doğrudan RAG ifadesi tercih edilmektedir.
RAG ile şirket verileri ChatGPT’ye bağlanabilir mi?
Uygun API ve yazılım mimarisi kurulduğunda şirketin izin verilen veri kaynakları büyük dil modeli tabanlı uygulamalarla ilişkilendirilebilir. Bunun doğrudan dosya yüklemekten farklı, kontrollü bir entegrasyon mimarisiyle yapılması daha sağlıklı olabilir.
RAG için vektör veritabanı şart mı?
Her RAG uygulamasında mutlaka vektör veritabanı kullanılması gerekmez. Kullanım senaryosuna göre klasik arama, SQL, API, keyword search, vector search veya hibrit yaklaşımlar kullanılabilir.
RAG ile PDF dosyaları sorgulanabilir mi?
Evet. PDF içerisindeki metin çıkarılabilir, uygun bölümlere ayrılabilir, indekslenebilir ve kullanıcı sorularına göre ilgili içerikler bulunabilir. Ancak taranmış belgelerde OCR, tablo yapıları ve karmaşık PDF düzenleri için ilave veri işleme gerekebilir.
RAG ile Excel dosyaları kullanılabilir mi?
Evet fakat Excel gibi yapılandırılmış verilerde kullanım amacına göre doğrudan tablo sorgulama yöntemleri RAG’dan daha uygun olabilir. Özellikle hesaplama ve kesin sayısal filtrelemelerde yapılandırılmış veri sorguları tercih edilebilir.
RAG ERP sistemine bağlanabilir mi?
ERP sisteminin API veya uygun entegrasyon imkânları bulunuyorsa yapay zekâ destekli uygulamalar ERP verileriyle ilişkilendirilebilir. Erişim izinleri ve veri güvenliği ayrıca planlanmalıdır.
RAG CRM sistemine bağlanabilir mi?
Evet. CRM verileri API, veri tabanı veya uygun entegrasyon katmanları üzerinden yapay zekâ sistemlerinde kullanılabilir. Böylece müşteri geçmişi, teklifler veya satış fırsatları doğal dil üzerinden sorgulanabilir.
RAG halüsinasyonu tamamen önler mi?
Hayır. RAG doğru kaynaklara erişimi artırabilir ancak yanlış retrieval, eski veri veya model yorumlama hataları nedeniyle yanlış cevaplar oluşabilir. Bu nedenle test ve değerlendirme mekanizması gereklidir.
RAG ile fine-tuning aynı şey mi?
Hayır. RAG modele dışarıdan bilgi sağlamaya odaklanırken fine-tuning model parametrelerinin ek eğitimle değiştirilmesidir. İki yöntem farklı sorunları çözmek için kullanılabilir ve gerektiğinde birlikte uygulanabilir.
Şirketin bütün verilerini RAG sistemine eklemek gerekir mi?
Hayır. Genellikle yalnızca belirlenen kullanım senaryosu için gerekli, güncel ve yetkilendirilmiş veri kaynaklarının sisteme dahil edilmesi daha doğru yaklaşımdır.
RAG sistemi şirket içinde çalıştırılabilir mi?
Kullanılan modeller ve altyapıya bağlı olarak bulut tabanlı, hibrit veya şirket içi sistemler tasarlanabilir. Seçim güvenlik, performans, maliyet ve teknik gereksinimlere göre yapılmalıdır.
RAG sistemi kaç günde yapılır?
Süre; veri miktarı, entegrasyon sayısı, kullanıcı yetkilendirmesi, kullanılacak model, arayüz, güvenlik ve test gereksinimlerine göre değişir. Basit pilot sistemlerle kapsamlı kurumsal platformlar aynı geliştirme süresine sahip değildir.
RAG sistemi maliyeti ne kadar?
Sabit bir RAG fiyatı bulunmaz. Veri hacmi, API kullanımı, model seçimi, sunucu altyapısı, kullanıcı sayısı, özel yazılım geliştirme ihtiyacı, entegrasyonlar ve bakım gereksinimleri bütçeyi etkiler.
RAG küçük işletmeler için uygun mu?
Evet. Binlerce çalışanı olmayan işletmelerde de teknik doküman arama, ürün bilgi asistanı, müşteri destek sistemi veya şirket içi bilgi bankası gibi sınırlı ve net kullanım senaryolarında değerlendirilebilir.
Şirketimize özel RAG sistemi için nereden başlamalıyız?
Önce çözülmesi gereken iş problemini ve kullanılacak veri kaynaklarını belirlemek gerekir. Reform Bilişim Teknolojileri ile şirketinizin yapay zekâ ve özel yazılım ihtiyaçlarını değerlendirebilirsiniz. İlk görüşme ücretsizdir.